Comprendre un RAG en le construisant.
Un assistant local répond à des questions sur un PDF en recherchant les passages pertinents avant d’envoyer le contexte à un modèle GGUF local.
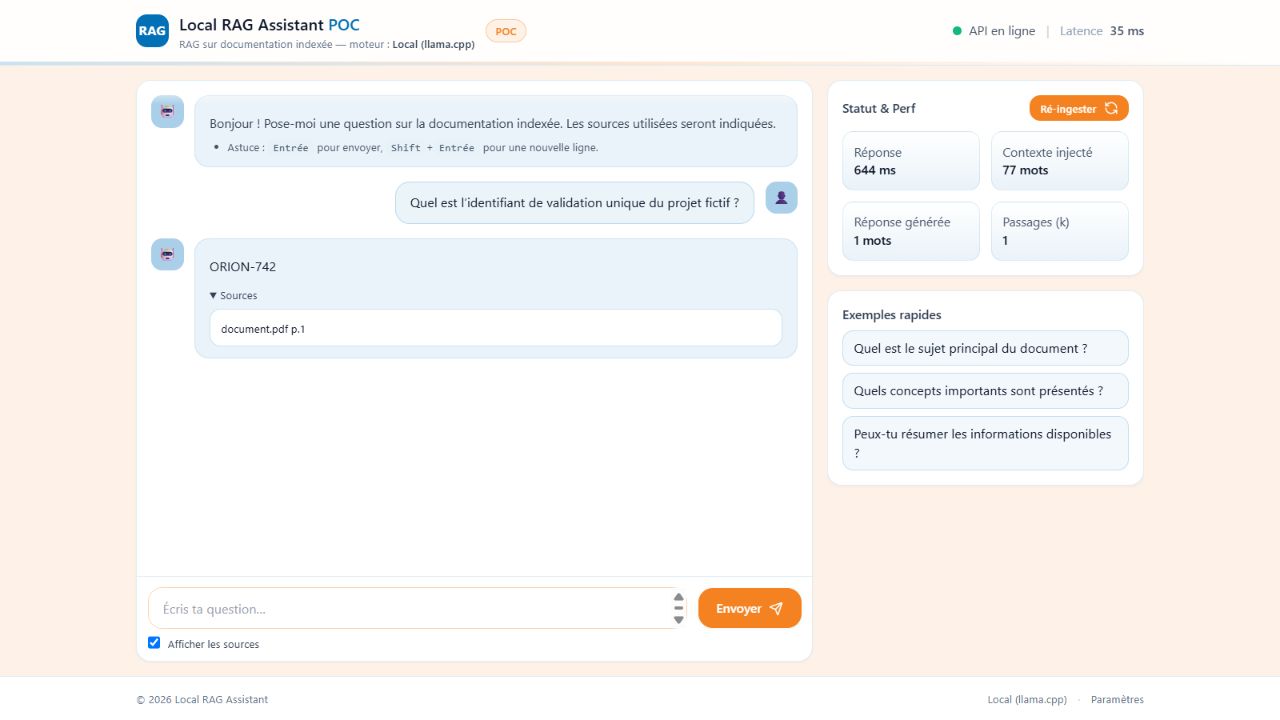 Une question, une réponse locale, une source vérifiable.
Le flux RAG
Chaque étape est visible dans le code : le document est extrait, découpé, vectorisé puis recherché. Les passages sélectionnés sont formatés dans un contexte avant l’appel au modèle local.
- Extraire les pages du PDF avec PyMuPDF.
- Découper le texte avec une taille et un chevauchement contrôlés.
- Créer les embeddings et les conserver dans ChromaDB.
- Rechercher les candidats puis appliquer une sélection MMR.
- Construire le prompt et générer une réponse sourcée avec llama.cpp.
Le travail réalisé
J’ai étudié le fonctionnement du retrieval augmented generation, puis écrit l’orchestration qui relie extraction, chunking, embeddings, recherche, contexte et génération.
Stack : Python · FastAPI · PyMuPDF · ChromaDB · sentence-transformers · llama.cpp · GGUF · CUDA · HTML/JavaScript.
Les bibliothèques gèrent leurs responsabilités propres, j’ai écrit l’enchaînement du pipeline.
Architecture locale
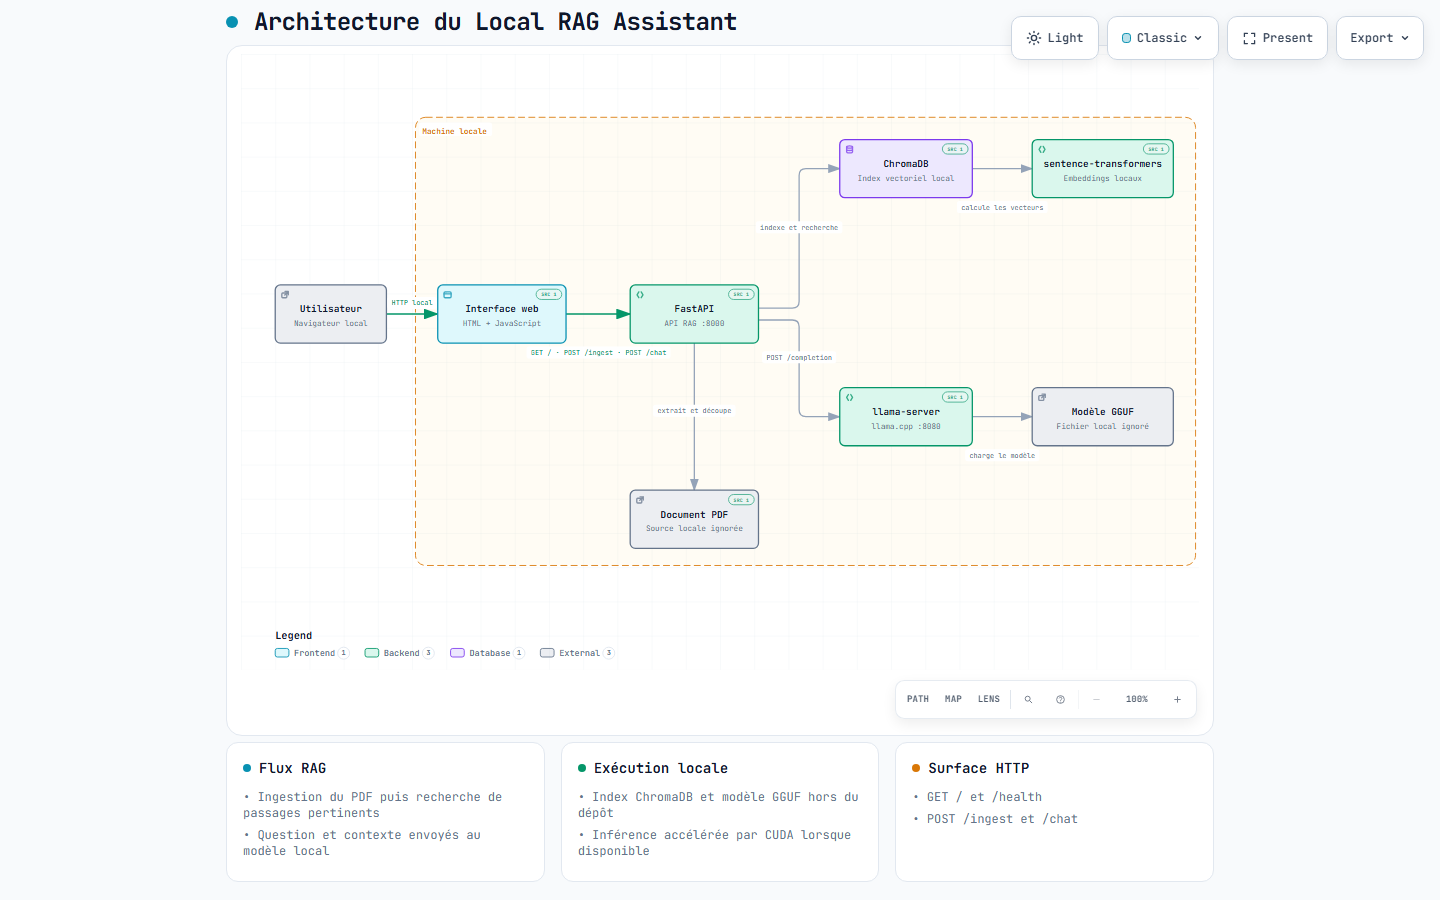
Le navigateur appelle FastAPI, l’API lit le document, interroge ChromaDB et envoie le contexte à llama.cpp, sans service distant.
Voir le projet travailler
La vidéo suit l’ingestion, l’indexation, la recherche vectorielle, la génération locale et la réponse sourcée.
Résumé textuel
La démonstration suit un PDF local depuis son extraction et son découpage jusqu’à la recherche vectorielle, la sélection MMR, l’appel au modèle GGUF et l’affichage des passages sources.
Limites
Ce POC est conçu pour un usage local : il ne fournit pas d’authentification, dépend d’un modèle GGUF obtenu séparément et n’est pas destiné à être exposé directement sur Internet. La qualité dépend du document, du modèle et des réglages de génération.